EM POUCAS LINHAS
- AISI e EvalEval divulgaram resultados acompanhados das condições de avaliação em 22 de setembro.
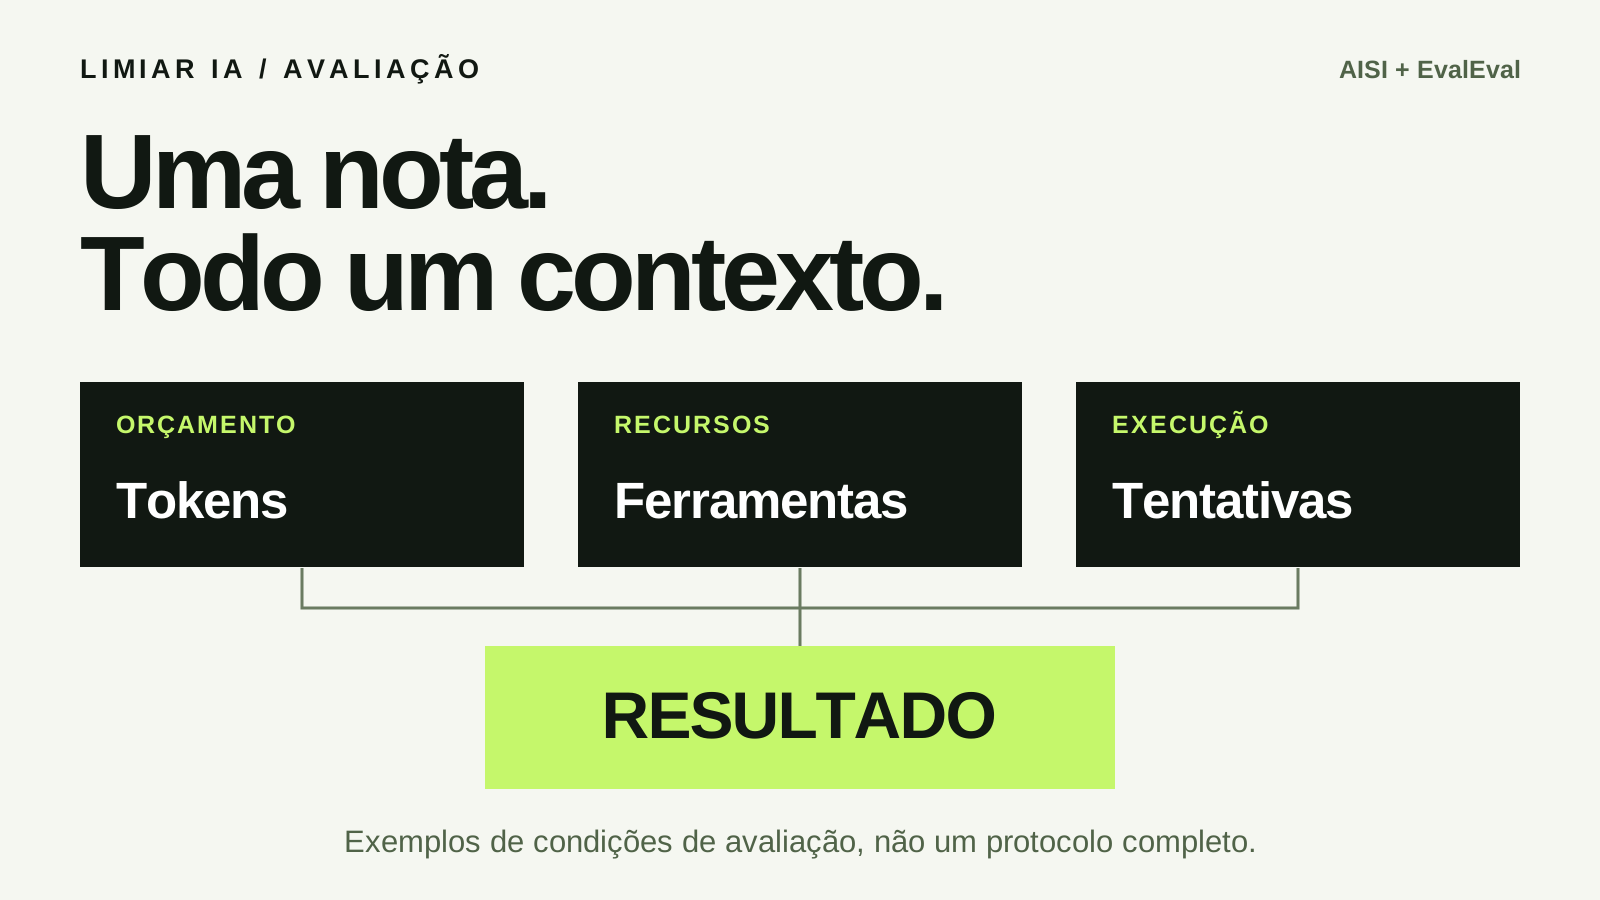
- Orçamento de tokens, ferramentas e novas tentativas podem mudar o desempenho observado.
- O selo das Evaluation Cards identifica a procedência da submissão; não comprova reprodução independente.
Uma nota alta em um benchmark de inteligência artificial depende de mais fatores que o nome do modelo. O orçamento de processamento, as ferramentas disponíveis e o número de tentativas podem mudar o resultado. Uma iniciativa anunciada em 22 de setembro de 2026 pela EvalEval Coalition e pelo UK AI Security Institute (AISI) busca tornar essas condições mais visíveis: o instituto britânico está usando a plataforma Evaluation Cards para compartilhar resultados, contexto e configurações de avaliação.
O que está sendo compartilhado
O anúncio conjunto publicado no Hugging Face cita HealthBench, FrontierMath, Humanity’s Last Exam, SWE-Bench Pro e Terminal-Bench 2.0. Os resultados principais abrangem Claude Opus 4, Opus 4.5, Opus 4.6, GPT-5, GPT-5.2 e GPT-5.4. A divulgação inclui também Cyber CTFs e The Last Ones, com modelos que não correspondem exatamente a essa lista.
Esses registros acompanham o estudo How Inference Compute Shapes Frontier LLM Evaluation. O trabalho foi submetido ao arXiv em 16 de junho de 2026, com a versão consultada revisada em 16 de julho. A novidade de setembro é a divulgação pela infraestrutura compartilhada; não o surgimento de um estudo inteiramente novo naquela semana.
A distinção evita uma leitura equivocada de atualidade. A pesquisa ajuda a entender como medir modelos, mas os modelos avaliados e os resultados devem ser interpretados nas condições e no período do experimento. O anúncio não apresenta um ranking definitivo dos melhores sistemas disponíveis hoje.
Por que mais processamento pode mudar a nota
O resumo do estudo descreve avaliações de até 12 modelos em sete benchmarks. Os pesquisadores combinaram três intervenções: ampliar o orçamento de tokens, compactar o contexto e permitir novas tentativas de resposta. Essas tentativas foram guiadas pelo próprio modelo ou por informação mínima sobre a correção da resposta.
Segundo os autores, orçamentos maiores aumentaram o desempenho em diferentes domínios, mas o ganho variou por benchmark e pelo método empregado. Eles defendem apresentar a capacidade como função do processamento utilizado, explicitar o protocolo e comparar gerações de modelos em uma faixa compartilhada de orçamento.
Em termos práticos, duas notas podem parecer equivalentes enquanto medem experiências bastante diferentes. Um sistema que recebe uma única tentativa e precisa responder rapidamente não está nas mesmas condições de outro que pode revisar o trabalho várias vezes e receber um sinal externo de acerto. O segundo resultado pode ser útil, desde que essas condições estejam visíveis.
Isso tem consequência econômica. Se um fornecedor alcançar melhor pontuação consumindo mais processamento, o ganho pode vir acompanhado de maior custo ou espera. A decisão depende do uso: uma análise demorada pode ser aceitável em pesquisa, mas inadequada para uma interação que precisa responder em poucos segundos.
O que as Evaluation Cards acrescentam
A documentação da plataforma descreve a combinação de dados de execução, informações sobre o benchmark e metadados do modelo. O objetivo é facilitar a leitura de quatro aspectos: reprodutibilidade, completude da documentação, procedência e comparabilidade.
O formato Every Eval Ever oferece campos para registrar quem executou a avaliação, sua relação com o desenvolvedor, configurações de geração e a definição da métrica. Também contempla informações de incerteza, como intervalos de confiança. Organizar esses dados ajuda a perceber quando duas notas semelhantes escondem protocolos diferentes.
Há uma distinção editorial importante no guia de verificação: o selo é atribuído a resultados enviados por uma conta Hugging Face associada à organização responsável. Isso oferece informação sobre procedência. Não deve ser descrito como certificado universal de precisão, auditoria independente ou garantia de que o resultado será reproduzido em qualquer ambiente.
Como isso ajuda quem escolhe IA no Brasil
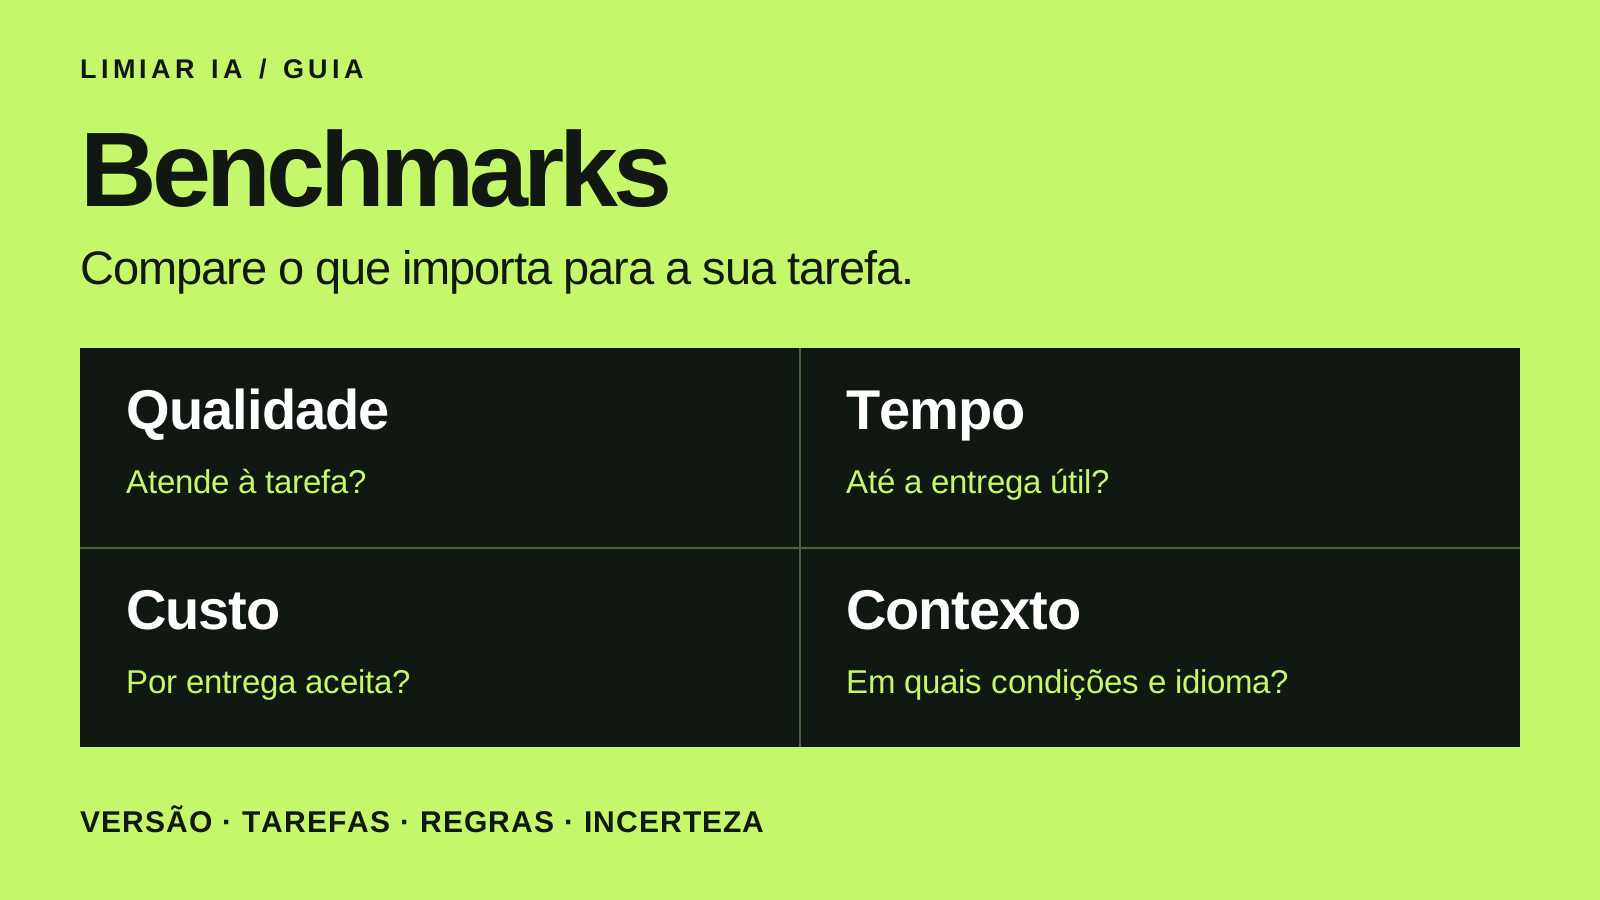
Empresas e desenvolvedores brasileiros podem usar essa abordagem para melhorar seus próprios testes. Antes de comparar fornecedores, vale fixar tarefas representativas, critérios de sucesso, orçamento e ferramentas disponíveis. Depois, medir custo, tempo e falhas junto com a qualidade da resposta.
Um exemplo hipotético é um assistente que responde dúvidas sobre documentos internos em português. A avaliação deveria incluir documentos e perguntas semelhantes aos do trabalho real, casos sem resposta na base e exigência de apontar a fonte usada. Um bom desempenho em matemática ou programação não demonstra automaticamente competência nesse atendimento.
Para quem paga APIs em moeda estrangeira, registrar o consumo por tarefa também permite estimar despesas em reais usando o câmbio e as condições de pagamento efetivos. O dado mais útil é quanto custa entregar uma resposta correta dentro do prazo necessário, incluindo revisões e novas tentativas.
Limites da iniciativa e desta análise
Documentação melhor facilita a interpretação; não elimina problemas como exposição prévia às tarefas, mudanças de versão, variabilidade entre execuções ou distância entre testes e uso cotidiano. A plataforma depende da informação disponibilizada pelos responsáveis. Campos preenchidos também precisam de exame crítico.
O Limiar IA verificou o anúncio, as datas e o resumo do estudo no arXiv, a documentação do Every Eval Ever, a apresentação das Evaluation Cards e os critérios do selo. Não reproduzimos os experimentos nem auditamos cada registro publicado. As implicações para o Brasil são análise editorial, não resultados medidos em uma amostra brasileira.
Para o leitor de rankings, a mudança mais útil é exigir que a nota venha acompanhada do método. Identificar o modelo, o teste e suas condições permite uma decisão muito mais informada sobre o que vale experimentar no próprio contexto.
Veja também o guia de leitura de benchmarks e um exemplo concreto de pontuação parcial versus sucesso no anúncio do Holo4.
Fontes e referências
- Anúncio da parceria EvalEval e AISIHugging Face / EvalEval · Consultado em 28/09/2026
- How Inference Compute Shapes Frontier LLM EvaluationarXiv / autores do estudo · Consultado em 28/09/2026
- Every Eval Ever: documentação do formatoEvalEval · Consultado em 28/09/2026
- Evaluation Cards: proposta e documentaçãoEvalEval · Consultado em 28/09/2026
- Critérios do selo de verificaçãoEvaluation Cards · Consultado em 28/09/2026