EM POUCAS LINHAS
- Benchmarks medem tarefas e condições específicas; não existe uma nota universal de inteligência.
- Compare versão, ferramentas, orçamento, incerteza e custo por tarefa concluída.
- Um roteiro com entradas fictícias em português ajuda a definir critérios antes de comparar; ele não demonstra o desempenho de nenhum modelo.
Um benchmark de IA é um conjunto de tarefas, regras e métricas usado para avaliar um sistema. Ele ajuda a comparar resultados sob condições definidas. Para escolher um modelo, porém, é preciso conectar essas condições ao trabalho que você pretende realizar.
Uma pontuação alta em programação pode dizer pouco sobre atendimento em português. Uma resposta preferida por usuários pode conter um erro factual. E um servidor que processa muitos tokens por segundo pode executar um modelo inadequado para sua tarefa. A leitura começa pela pergunta que cada avaliação consegue responder.
O que as principais referências de avaliação medem
| Referência | O que avalia | O que observar |
|---|---|---|
| SWE-bench | Resolução de problemas de software a partir de issues reais de repositórios. | Conjunto de tarefas, agente, ferramentas e orçamento de execução. |
| HELM, de Stanford | Avaliação ampla de modelos em diferentes cenários e métricas. | Capacidades cobertas, lacunas e desempenho em cada cenário. |
| Open LLM Leaderboard | Uma combinação documentada de tarefas de conhecimento, raciocínio e seguimento de instruções. | Versão da avaliação, subtarefas, normalização e configuração. |
| Arena | Preferência de pessoas entre respostas de modelos inicialmente anônimos. | Categoria, quantidade de votos, incerteza e perfil das tarefas. |
| MLPerf Inference | Desempenho de sistemas que executam inferência, sob regras de qualidade e carga. | Hardware, software, cenário, latência, vazão e divisão da submissão. |
O HELM é uma boa referência conceitual: sua proposta original, publicada em 2022, combina acurácia com calibração, robustez, equidade, vieses, toxicidade e eficiência. Também explicita o que ficou fora da avaliação. Esse hábito evita transformar uma medida parcial em uma declaração de superioridade geral.
Leia o protocolo antes da pontuação
Comece pelo nome completo do modelo e pela versão do benchmark. Uma família pode incluir variantes com capacidades, preços e configurações diferentes. Modelos oferecidos por API também podem receber atualizações; registre a versão disponível e a data da avaliação.
Confira depois quais recursos estavam liberados. O sistema pôde pesquisar na internet, executar código ou consultar arquivos? Quantas tentativas recebeu? Qual foi o limite de tokens e de tempo? Um resultado com várias tentativas representa uma condição diferente de uma execução única.
No SWE-bench, a métrica publicada é a porcentagem de instâncias resolvidas. A página oficial distingue conjuntos como Verified e Lite e apresenta uma visualização com modelos no mesmo ambiente de agente. Isso importa porque o resultado envolve o modelo, as ferramentas e a forma de conduzir a tarefa. Comparar agentes com orçamentos distintos exige deixar essa diferença visível.
No Open LLM Leaderboard, a documentação informa tarefas, métricas e quantidade de exemplos usados no prompt. Também registra detalhes de reprodução, como a aplicação do formato de conversa. Essas escolhas fazem parte do resultado.
Preferência humana e correção respondem a perguntas diferentes
Na Arena, a pessoa envia uma solicitação, compara duas respostas sem conhecer inicialmente os modelos e vota na preferida. É uma maneira útil de observar a experiência de uso, incluindo clareza, utilidade percebida e estilo.
Para avaliar uma afirmação factual, ainda é necessário conferir suas evidências. Um texto agradável pode apresentar uma referência inexistente; uma resposta curta e correta pode perder a preferência para outra mais elaborada. Além disso, os participantes e as perguntas da plataforma não representam automaticamente todos os públicos brasileiros.
O ranking de texto da Arena apresenta informações de votos e intervalos de confiança. Diferenças pequenas exigem cautela: o número da posição, isoladamente, esconde a incerteza. Sobreposição de intervalos também não basta, por si só, para concluir equivalência estatística entre dois modelos.
Uma média pode esconder a tarefa que mais importa
Uma pontuação agregada resume várias tarefas. Para um negócio, porém, os pesos raramente são iguais. Um assistente de suporte precisa localizar informações corretas e reconhecer quando falta contexto. Um extrator de dados precisa preservar valores e devolver um formato válido. Um programador depende da qualidade das alterações e dos testes.
Veja as subtarefas antes da média e confira como ela foi calculada. Percentuais de benchmarks distintos não formam uma escala universal: os dados, a dificuldade e o critério de acerto mudam.
Também considere saturação e contaminação. Quando quase todos acertam um conjunto, ele passa a distinguir pouco os sistemas. Quando exemplos da avaliação aparecem no treinamento, a nota pode refletir familiaridade com o material. A documentação da Hugging Face discute dificuldade e contaminação ao contextualizar o MMLU-Pro. Isso é motivo para examinar a avaliação, sem acusar um modelo específico sem evidências.
Português brasileiro merece uma avaliação própria
Inclua tarefas do seu público: textos com abreviações, valores com vírgula decimal, datas brasileiras, nomes locais e perguntas formuladas de maneiras diferentes. Um modelo pode escrever português fluente e ainda interpretar incorretamente um documento ou uma regra de negócio.
Use exemplos autorizados, anonimizados ou fictícios. Se a tarefa depende de uma fonte, entregue o mesmo material aos candidatos e confira se a resposta respeita o conteúdo. Para notícias, peça distinção entre anúncio, disponibilidade efetiva e promessa futura. Avalie também o comportamento quando a informação necessária está ausente.
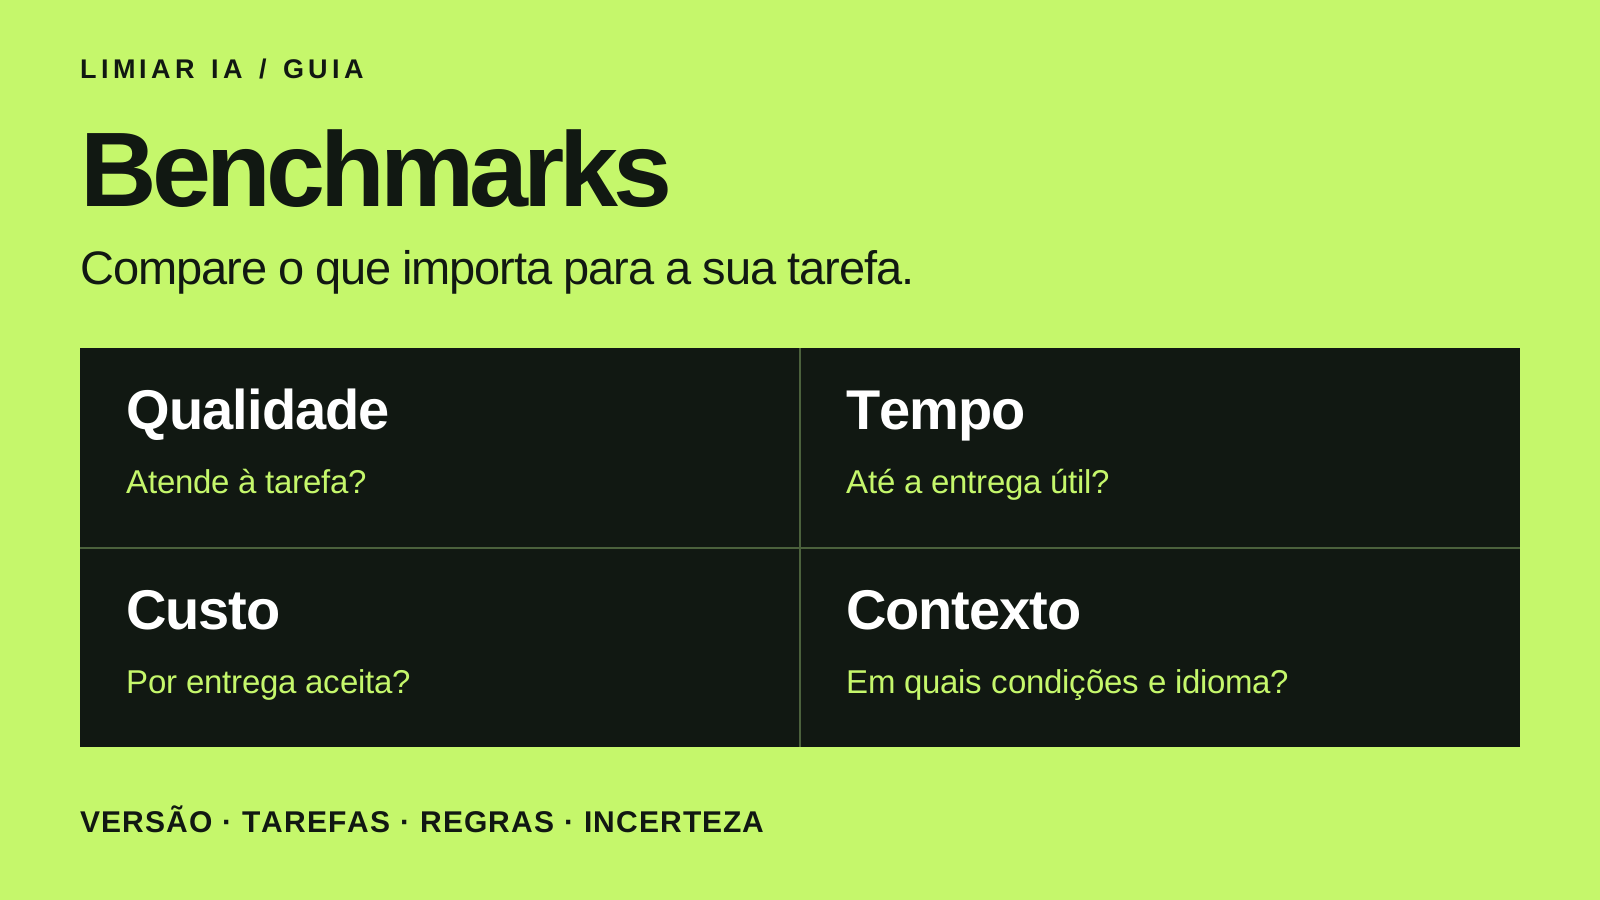
Compare o custo de terminar o trabalho
O preço por milhão de tokens ajuda a estimar despesas, mas a conta inclui entrada, saída, ferramentas, repetições e revisão. Considere ainda hospedagem e operação se o modelo rodar na sua infraestrutura. Para comparar provedores cobrados em moedas diferentes, registre a moeda original, a data e a taxa de conversão utilizada.
Uma medida prática é o custo por tarefa aceita: divida o gasto total da avaliação pelo número de entregas que passaram pelos seus critérios. Defina esses critérios antes de observar o vencedor. Se nenhuma entrega passar, a configuração precisa ser revista antes de entrar em uso.
Meça o tempo até a resposta útil e os atrasos nos casos mais lentos. No MLPerf, os resultados dependem do cenário e de regras de desempenho e qualidade; as divisões Open e Closed têm permissões diferentes. Uma medição de infraestrutura precisa ser lida com esses detalhes para orientar uma decisão de implantação.
Um roteiro para escolher seu modelo
- Defina a tarefa e os limites. Escreva o que constitui uma entrega correta e quais erros impedem o uso, mesmo com uma média alta.
- Monte uma amostra representativa. Inclua casos comuns, difíceis e ambíguos. Algumas dezenas de tarefas podem ajudar na triagem; uma amostra pequena não demonstra confiabilidade em escala.
- Mantenha condições comparáveis. Use os mesmos materiais, ferramentas e limites. Registre ajustes específicos de cada modelo.
- Avalie com critérios prévios. Quando possível, esconda a identidade do modelo de quem revisa. Separe correção, completude, formato e necessidade de intervenção.
- Guarde falhas e despesas. Registre todas as execuções consideradas, inclusive erros, recusas e repetições. Exemplos escolhidos apenas por serem bons distorcem a conclusão.
- Reavalie após mudanças. Uma atualização do modelo, dos documentos ou do fluxo pode alterar o desempenho. Preserve versões para entender a diferença.
Uma avaliação pequena em português para reproduzir
O roteiro abaixo é uma proposta editorial com documentos inteiramente fictícios. Ele ilustra o cuidado com tarefa, idioma, critérios e condições comparáveis discutido pelo HELM. Não executamos os casos em modelos; as respostas esperadas vêm das entradas construídas para este exemplo. Três casos servem para aprender a montar uma avaliação, não para representar o português brasileiro ou aprovar um sistema de produção.
Use a mesma instrução em cada caso: “Leia apenas o documento fornecido. Devolva somente um objeto JSON com as chaves emissao, total e vencimento. Preserve datas no formato dia/mês/ano e valores como escritos no documento. Se um campo não estiver informado, use null. Quando houver rascunho e versão vigente, use a versão vigente.”
| Caso fictício | Documento a fornecer | Resposta esperada |
|---|---|---|
| Valores e datas locais | Pedido A. Emissão: 03/10/2026. Total: R$ 1.234,50. Vencimento: 10/10/2026. | {"emissao":"03/10/2026","total":"R$ 1.234,50","vencimento":"10/10/2026"} |
| Abreviação e informação ausente | Pedido B. Dt. de emissão: 03/10/2026. Vlr. total: R$ 89,90. | {"emissao":"03/10/2026","total":"R$ 89,90","vencimento":null} |
| Documentos conflitantes | Pedido C, versão vigente: emissão em 03/10/2026, total de R$ 240,00 e vencimento em 10/10/2026. Rascunho não aprovado do pedido C: vencimento em 20/10/2026. | {"emissao":"03/10/2026","total":"R$ 240,00","vencimento":"10/10/2026"} |
Defina o aceite antes da execução. Neste exercício, a saída precisa ser JSON válido, conter exatamente essas três chaves e preservar os valores esperados, inclusive null. A ordem das chaves e os espaços de formatação fora das strings não mudam o resultado. Uma data trocada, um total alterado ou um vencimento inventado reprovam o caso, mesmo quando o restante está correto. Registre separadamente falha de formato e falha de conteúdo para saber o que corrigir.
Anote modelo e versão, provedor, instrução completa, documentos, configuração de raciocínio, ferramentas liberadas, limites e horário. Guarde resposta bruta, consumo informado, tempo observado e motivo da decisão. Se a avaliação permitir correção, separe o resultado da primeira tentativa do resultado após intervenção e registre todo o gasto; escolher só a melhor resposta esconde falhas.
Uma rodada didática pode repetir cada caso três vezes, sempre em uma nova sessão com as mesmas entradas. Mantenha esse número fixo ao comparar configurações. Observe tanto o total de acertos quanto quais casos passaram em todas as repetições: a pesquisa da IBM Research sobre consistência de agentes explica por que a média não responde sozinha à pergunta sobre repetibilidade. Aplicar esse princípio aqui é uma proposta de avaliação, não uma reprodução do experimento da IBM nem um resultado medido pelo Limiar.
Antes de ampliar o uso, acrescente casos autorizados representativos do seu trabalho e reserve uma parte deles para avaliar a versão final, sem usá-los para ajustar instruções. Inclua erros e situações ambíguas; quando uma falha tiver consequência relevante, defina também o encaminhamento para revisão. Nenhuma taxa obtida nesse conjunto pequeno deve ser apresentada como confiabilidade geral. Para fluxos com várias ferramentas, complemente o roteiro com a checagem da procedência de cada afirmação.
Exemplo hipotético de custo por entrega aceita
Considere duas configurações fictícias, A e B, submetidas às mesmas dez tarefas com os mesmos critérios. Suponha que os gastos abaixo incluam todas as chamadas e repetições da rodada, mas não o trabalho de revisão humana. São números inventados apenas para explicar a conta, sem relação com tarifas ou desempenho de qualquer produto.
| Configuração fictícia | Gasto da rodada | Tarefas aceitas | Gasto dividido pelas tarefas aceitas |
|---|---|---|---|
| A | US$ 5,00 | 8 de 10 | US$ 0,625, aproximadamente US$ 0,63 |
| B | US$ 4,00 | 5 de 10 | US$ 0,80 |
Nesse cenário hipotético, B gasta menos no total, mas A custa menos por tarefa aceita. A conta só é comparável porque ambas receberam as mesmas tarefas e critérios e contabilizaram as tentativas no mesmo escopo. Qualidade, tempo e esforço de revisão continuam relevantes. Se nenhuma tarefa for aceita, não há custo por entrega aceita finito a reportar: registre o gasto e a ausência de entregas, sem dividir por zero.
Para explorar a parcela de consumo, o comparador de IAs do Limiar oferece uma simulação de tarifas-base por tokens para os modelos e provedores de sua amostra. Confira as datas, as condições da fonte e a configuração de cada item. A ferramenta não mede a quantidade de tentativas que o seu trabalho exigirá nem transforma uma tarifa baixa em melhor desempenho. O custo efetivo precisa incluir os demais componentes cobrados no seu fluxo; se incorporar revisão humana, explicite a forma de contabilizá-la.
Benchmarks públicos ajudam a selecionar candidatos. A decisão final ganha força quando combina essas referências com evidências do seu próprio uso. A melhor escolha é aquela que atende aos critérios da tarefa com custo e tempo aceitáveis, dentro das condições que você consegue manter.
Nota editorial: este guia foi elaborado com apoio de IA a partir das fontes primárias citadas, reconsultadas em 03/10/2026. Não executamos testes próprios de modelos para este artigo e não apresentamos um ranking de desempenho. As entradas, os critérios e os números dos exercícios acima são materiais didáticos hipotéticos.
Na cobertura do Limiar, aplicamos esses critérios ao lançamento do Holo4 e à iniciativa de transparência do AISI e da EvalEval.
Atualização de 03/10/2026: acrescentamos casos fictícios em português com critérios de aceitação, orientações de registro e repetibilidade, um exemplo de custo por entrega aceita e links para o comparador e a análise de procedência. A primeira data de publicação foi preservada.
Fontes e referências
- SWE-bench: avaliações e conjuntos de tarefasSWE-bench · Consultado em 03/10/2026
- HELM: Holistic Evaluation of Language Models (2022)Stanford CRFM · Consultado em 03/10/2026
- MLPerf Inference: DatacenterMLCommons · Consultado em 03/10/2026
- Open LLM Leaderboard: metodologiaHugging Face · Consultado em 03/10/2026
- Como funciona a ArenaArena · Consultado em 03/10/2026
- Arena: avaliações de textoArena · Consultado em 03/10/2026
- Your Agent Aced the Task. Will It Do It Again?IBM Research no Hugging Face · Consultado em 03/10/2026