EM POUCAS LINHAS
- Os resultados publicados não colocam os dois modelos frente a frente no mesmo teste de programação.
- As tarifas padrão anunciadas coincidem para entrada e saída, mas não para as categorias de cache informadas.
- Acesso geral anunciado não confirma disponibilidade efetiva nem custo final no Brasil.
- A escolha depende de medir qualidade, consumo de tokens e esforço nas tarefas da própria equipe.
Para escolher um modelo de programação, a pergunta útil não é qual anúncio traz a maior pontuação, mas qual entrega mudanças aproveitáveis no seu fluxo de trabalho, sob um custo verificável. A OpenAI apresenta o GPT-6.1 Sol como evolução para escrever e depurar código; a Anthropic apresenta o Claude Sonnet 5.5 como opção forte para tarefas cotidianas bem delimitadas, incluindo corrigir bugs. São propostas que se sobrepõem, mas as evidências divulgadas não formam um teste direto entre elas.
O que foi anunciado — e quando
A página da Anthropic traz a data de 28 de setembro de 2026 para a apresentação do Sonnet 5.5. O texto fornecido da página da OpenAI anuncia o GPT-6.1 Sol e seu acesso, mas não permite confirmar o dia de publicação; portanto, não cabe atribuir-lhe uma data específica. Essas datas de apresentação não são datas de execução dos estudos de desempenho: as páginas descrevem avaliações, mas não estabelecem uma cronologia comum de testes que autorize tratá-las como uma disputa simultânea.
No posicionamento da OpenAI, o Sol atualizado melhora em tarefas profissionais que vão da programação a fluxos de trabalho com várias etapas. A Anthropic, por sua vez, distingue o Sonnet 5.5 do Opus 5.5: apresenta o primeiro para trabalho cotidiano delimitado e o segundo para problemas complexos que exigem julgamento prolongado. Isso ajuda a identificar casos de uso, mas é descrição dos fabricantes, não garantia de qualidade em um repositório específico. Quem quiser aprofundar a comparação dentro de cada família pode consultar as análises do GPT-6.1 Sol frente ao GPT-6 Sol e do Sonnet 5.5 frente ao Opus 5.5.
Por que as notas não apontam um vencedor
Em programação, a OpenAI declara que o GPT-6.1 Sol iguala o GPT-6 Astra no DeepSWE v1.1 com aproximadamente um quinto do custo por tarefa, além de superar a melhor nota do GPT-6 Sol em 6,4 pontos percentuais sob menor esforço de raciocínio e custo. O comparador aí é outro modelo da OpenAI, não o Sonnet 5.5.
A Anthropic informa que o Sonnet 5.5 obteve 70,6% no Terminal-Bench 4.0, contra 10,3% do Sonnet 5. Essa também é uma comparação com o antecessor. Na tabela de FrontierCode 1.1 da mesma página, o modelo da OpenAI listado é o GPT-6 Sol, não o GPT-6.1 Sol; para Terminal-Bench 4.0, a Anthropic afirma apresentar o GPT-5.6 Sol porque não havia resultado público do GPT-6 Sol naquele teste. Não se deve transportar nenhuma dessas notas para o modelo mais recente.
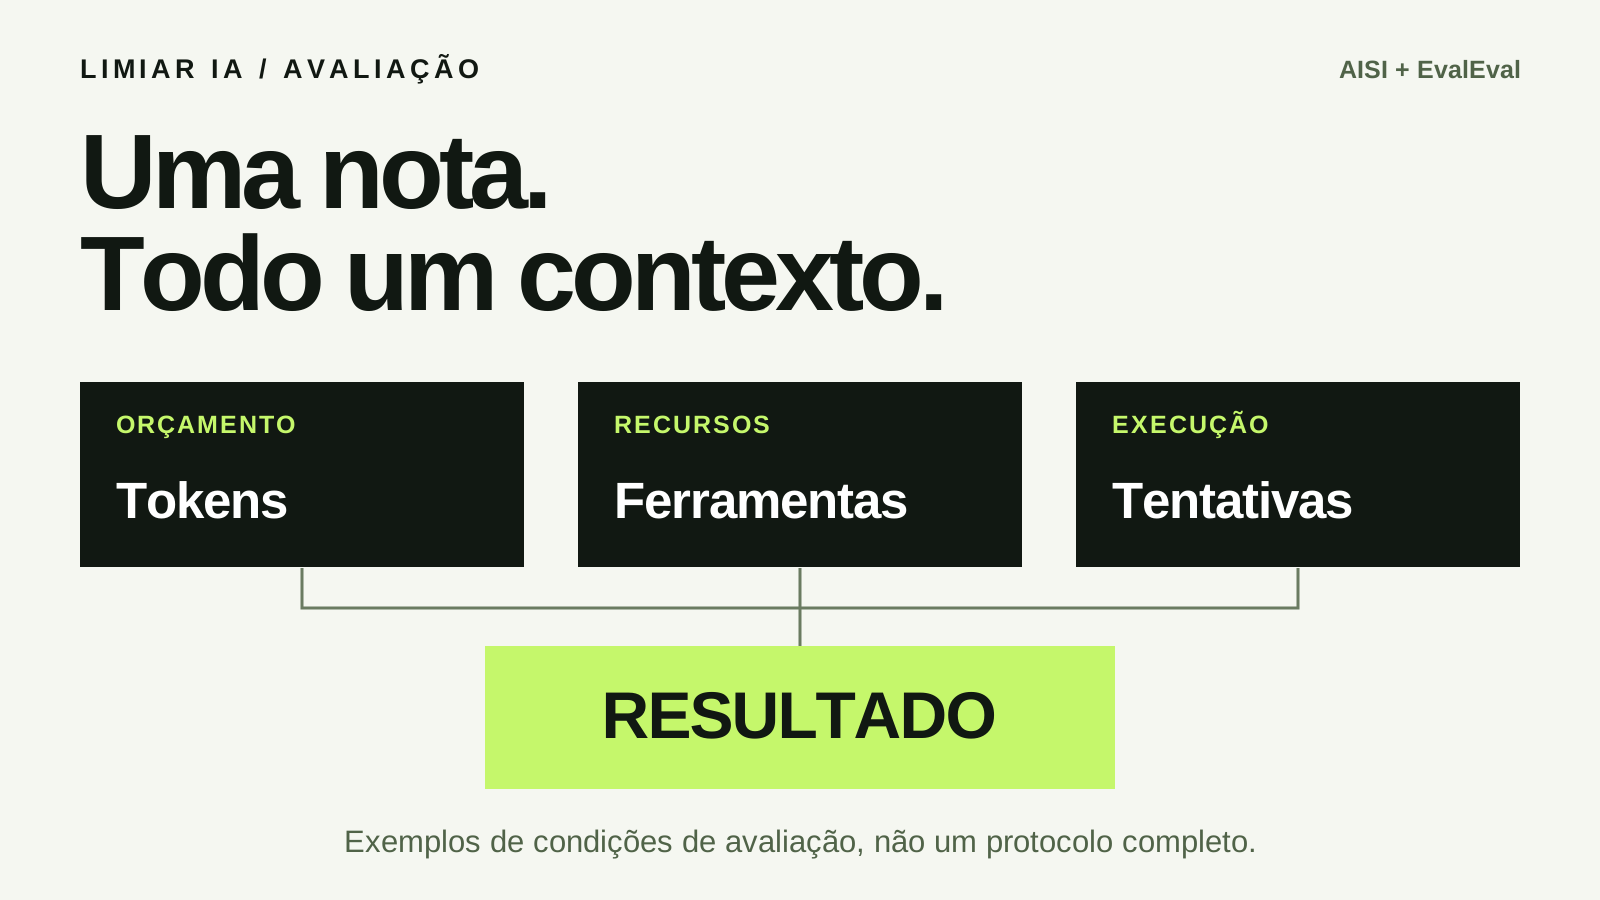
Mesmo quando há nomes de avaliações parecidos, importa conferir conjunto de tarefas, ferramentas do agente, tentativas e orçamento de raciocínio. A OpenAI adverte que suas avaliações ocorreram em ambiente de pesquisa ou pela API e podem diferir do ChatGPT de produção; os resultados de concorrentes vieram de relatórios públicos. A Anthropic observa que benchmarks representam apenas uma faceta das capacidades. As duas páginas, assim, sustentam hipóteses de avaliação, não uma classificação independente entre os lançamentos. Há um guia do acervo sobre leitura de benchmarks para estruturar essa conferência.
Tarifa igual não significa mesma conta
Nas tarifas padrão de API divulgadas, OpenAI e Anthropic informam US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída. Para cache, as categorias anunciadas diferem: a OpenAI informa US$ 0,10 por milhão de tokens de entrada em cache, enquanto a Anthropic informa US$ 0,20 por milhão de tokens de leituras de cache e US$ 2,50 por milhão de gravações de cache. Não é seguro equiparar as condições de cobrança dessas categorias apenas pelo nome.
Uma tarefa pode consumir volumes diferentes de entrada, saída e cache conforme o tamanho do repositório, as chamadas de ferramentas e a quantidade de revisões necessárias. A Anthropic afirma que, em seus testes, o Sonnet 5.5 custa até 30% menos por tarefa que o Sonnet 5; isso não é uma economia medida diante do GPT-6.1 Sol. Ela também informa que o esforço padrão é Medium no Claude Code e em seus aplicativos, mas High na Claude Platform. Comparar somente a tabela de preços ou notas obtidas com esforços diferentes pode ocultar o custo de chegar a uma alteração aceitável.
Acesso e decisão prática no Brasil
Segundo a OpenAI, o GPT-6.1 Sol está disponível na API como gpt-6.1-sol e em ChatGPT Work e Codex para usuários dos planos Plus, Pro, Business, Enterprise e Edu listados; a empresa diz que ele ainda não está disponível em Chat. A Anthropic informa acesso ao Sonnet 5.5 pela Claude Platform como claude-sonnet-5-5 e anuncia disponibilidade também em AWS, Google Cloud e Azure. Anúncio de canal de acesso não confirma que uma conta brasileira específica esteja habilitada.
As páginas consultadas não comprovam preço final em reais, impostos aplicáveis, condições locais de contratação nem disponibilidade efetiva para cada organização no Brasil. Para uma equipe brasileira, o próximo passo é verificar essas condições nos canais que pretende usar e definir uma amostra própria de tarefas: corrigir um bug com teste de regressão, modificar arquivos relacionados e revisar se a mudança respeita o escopo. Esse é um exemplo hipotético de protocolo, não um teste realizado para este artigo. Registrar acerto, tempo, tokens consumidos, configurações de esforço e intervenções humanas permitiria comparar custo por mudança aceita, em vez de declarar vencedor a partir de lançamentos com métricas distintas.
Fontes e referências
- Introducing GPT-6.1 Sol | OpenAIOpenAI News · Consultado em 01/10/2026
- Introducing Claude Sonnet 5.5 \ AnthropicAnthropic News · Consultado em 01/10/2026