EM POUCAS LINHAS
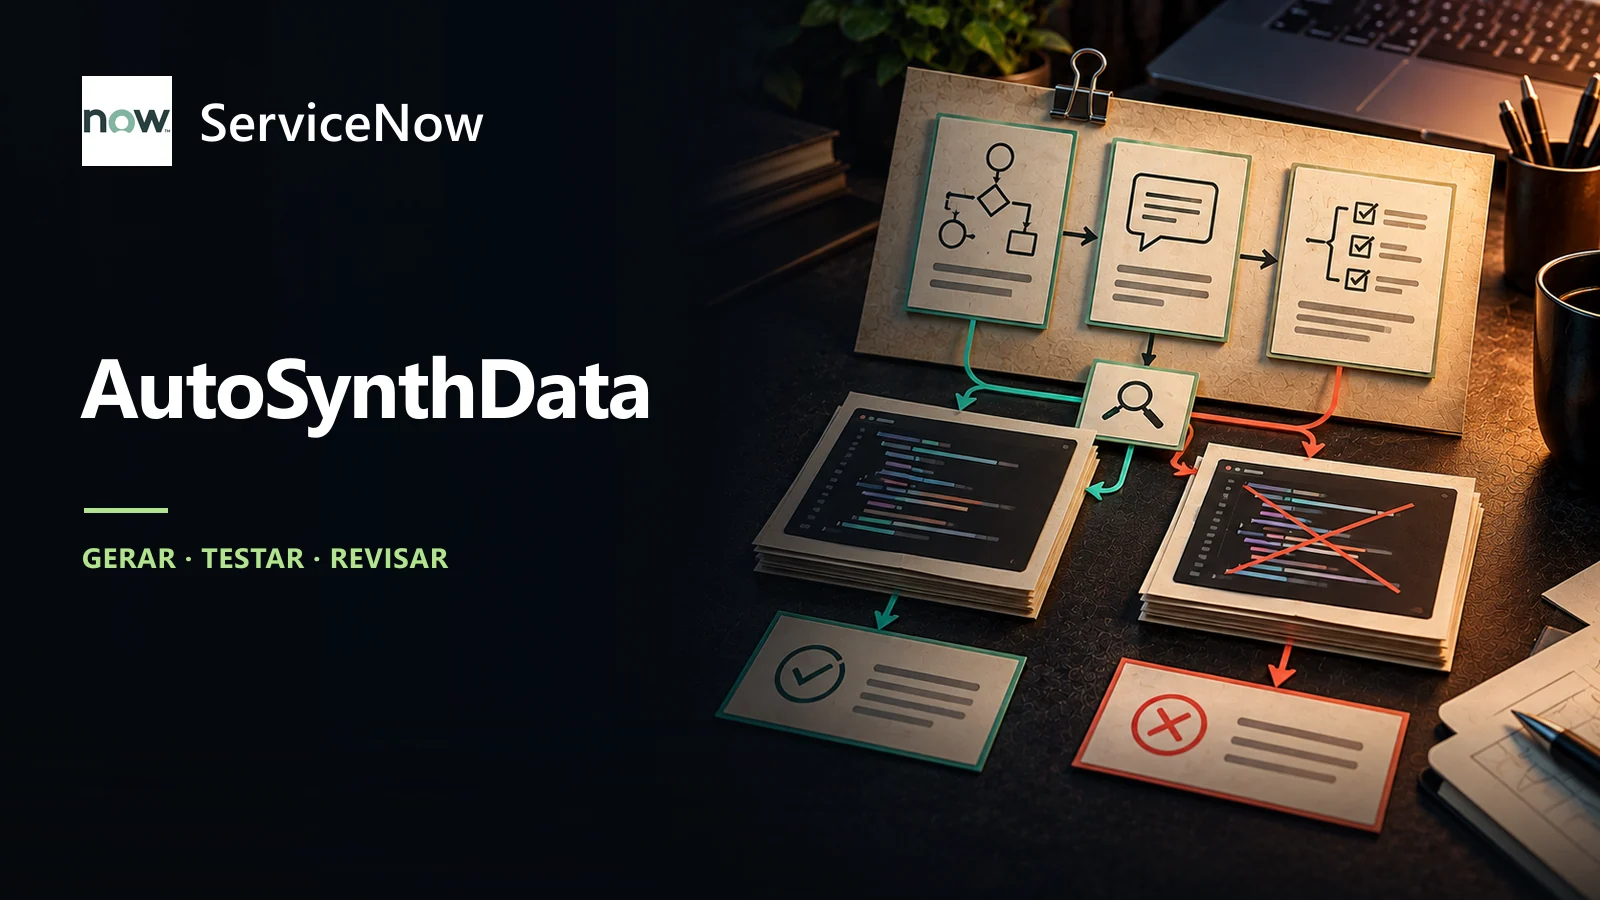
- O gerador parte de lacunas de capacidade e cria tarefas novas com estado, solicitação e verificador.
- Testes positivos e negativos procuram detectar soluções inviáveis e verificadores permissivos.
- Ganhos relatados em um ambiente experimental não demonstram consistência entre execuções nem desempenho no Brasil.
A pergunta não é apenas se uma IA consegue inventar solicitações plausíveis para um agente empresarial. É se essas solicitações podem ser executadas no sistema em questão, se ensinam algo que o agente ainda não domina e se o critério de aprovação reconhece tanto o acerto quanto o erro. Esse é o problema que os pesquisadores da ServiceNow dizem enfrentar com o AutoSynthData, em artigo publicado em 2 de outubro de 2026. A data é a da publicação do relato, não uma data estabelecida para os experimentos ou um anúncio de disponibilidade pública do sistema.
Das falhas às tarefas novas
No relato da ServiceNow, uma tarefa combina especificação do sistema, pedido do usuário e verificador. A especificação delimita regras, ferramentas e, quando necessário, o estado inicial do ambiente; o pedido define o objetivo; o verificador julga o resultado. Isso desloca a atenção da aparência convincente do texto para a possibilidade de executar o fluxo e conferir seu desfecho.
O processo descrito começa com a avaliação de um modelo-alvo e de um solucionador mais forte em tarefas diagnósticas. Os pesquisadores analisam onde o primeiro falha, como o segundo chega a um resultado e que propriedades o estado final precisa apresentar. Em seguida, condensam as lacunas em cartões de especificação de capacidade: segundo os autores, o gerador recebe esses cartões, mas não os prompts, entidades, trajetórias ou detalhes dos verificadores das tarefas originais de avaliação (ServiceNow). Essa separação pretende reduzir a reprodução direta dos exemplos avaliados; sozinha, não prova generalização para fluxos diferentes.
A geração tem uma etapa de amostras centrais e outra de expansão a partir das amostras aceitas. Cada variante deve trazer seu próprio pedido, estado, configuração de entidades, trajetória de referência e verificador, além de passar pelos mesmos controles; uma variante expandida não serve de origem para outra (ServiceNow). A restrição procura conter o afastamento progressivo da tarefa inicial validada, mas variedade de redação não equivale necessariamente a variedade de capacidades.
O que significa verificar uma tarefa sintética?
Para ser útil, uma tarefa precisa admitir ao menos uma solução permitida pelas regras e ferramentas disponíveis, parecer um pedido plausível naquele ambiente e desafiar o agente atual. São os critérios de viabilidade, realismo e dificuldade apresentados pelos autores. Um pedido impossível pode ensinar um comportamento inadequado; um pedido fácil e repetido tende a acrescentar pouco sinal de treinamento. Já o realismo não se resolve somente com execução técnica: depende de o fluxo corresponder ao trabalho que usuários realmente solicitariam.
O verificador também precisa corresponder ao pedido e ao estado do sistema. Segundo a descrição do método, o teste positivo executa uma trajetória de referência no ambiente e confere se o estado obtido é aceito; o negativo altera resultados esperados para conferir se desfechos incorretos são rejeitados. Esses testes detectam, respectivamente, incompatibilidades entre instrução, solução e critério de êxito, e regras permissivas demais. Não garantem, por si, que toda solução válida seja aceita ou que todo modo inesperado de falhar seja rejeitado: os casos escolhidos para testar o verificador também importam.
Antes da aceitação, a configuração descrita favorece tarefas que o modelo-alvo resolve em no máximo uma de três tentativas e o solucionador mais forte em pelo menos duas de três (ServiceNow). Isso procura situar a dificuldade entre o trivial e o impossível. Candidatas que falham podem passar por diagnóstico, reparo limitado e nova checagem; a equipe também descreve revisão de lotes para observar cobertura, repetição e áreas com muitas rejeições. Convém não confundir esse processo de controle descrito pelos criadores com uma auditoria independente das tarefas aceitas.
O que os resultados mostram — e o que não mostram
No domínio Hybrid do EnterpriseOps Gym, os autores relatam a geração de 2.000 amostras sintéticas e, após ajuste fino supervisionado do modelo-alvo, ganho de 7,2 pontos percentuais em mean Pass@1 para o checkpoint selecionado (ServiceNow). No domínio ITSM do mesmo ambiente, relatam 1.994 amostras e aumento da métrica de 18,77% para 27,18% (ServiceNow). São resultados apresentados pelos próprios criadores em domínios experimentais; não constituem medição de sucesso em sistemas reais de empresas nem avaliação independente do AutoSynthData. O artigo não estabelece a data em que esses experimentos foram realizados.
A métrica de acerto merece uma pergunta adicional: o agente repetiria o resultado? Em pesquisa distinta, os pesquisadores da IBM distinguem a média de acertos em execuções repetidas, a proporção de tarefas acertadas em todas as execuções (Pass^k) e aquela em que ao menos uma tentativa dá certo (Pass@k). O trabalho da IBM avalia outro método, em outro ambiente: não confirma nem contesta o desempenho do AutoSynthData. Ele ajuda a explicar por que o ganho em mean Pass@1 divulgado pela ServiceNow não demonstra, isoladamente, que a mesma tarefa terá êxito repetido. Para essa conclusão, seria preciso avaliar o agente treinado em múltiplas execuções das mesmas tarefas e publicar também a distribuição de falhas, não apenas o resultado agregado. A distinção entre capacidade média e repetibilidade já orienta a discussão do acervo sobre consistência de agentes; aqui ela se aplica especificamente a tarefas sintéticas de treinamento.
O que faltaria para decidir pelo uso
Uma avaliação mais convincente separaria tarefas de treinamento e teste por fluxos, estados e capacidades, examinaria manualmente amostras e verificadores sob critérios declarados e compararia o desempenho antes e depois em tarefas que não tenham servido à construção dos cartões. São propostas de verificação, não procedimentos que esta apuração tenha realizado. Medir falhas por tipo de tarefa e repetibilidade ajudaria a distinguir aprendizado transferível de melhora concentrada nos padrões gerados. Os experimentos apresentados pela ServiceNow concentram-se em ajuste fino supervisionado; aplicar o mecanismo a aprendizado por reforço é uma possibilidade que os autores dizem pretender testar, não um resultado já demonstrado.
Para uma empresa brasileira, um exemplo hipotético seria gerar pedidos sobre atendimento interno usando suas ferramentas e políticas próprias e verificar se a atualização de um chamado deixa o estado correto sem violar restrições. Nada nas evidências apresentadas demonstra implantação local, desempenho em português brasileiro ou aderência a esses sistemas específicos. Também permanecem pendentes condições de acesso, licença, preço e requisitos para reproduzir o método. A conclusão prática é condicional: tarefas sintéticas só ajudam se o ambiente, as soluções e os verificadores representarem o trabalho que se quer melhorar — e se o ganho persistir fora das tarefas usadas para produzi-las.
Fontes e referências
- AutoSynthData: Generating Training Data for Enterprise Agentshuggingface.co · Consultado em 03/10/2026
- Your Agent Aced the Task. Will It Do It Again?huggingface.co · Consultado em 03/10/2026