EM POUCAS LINHAS
- Uma demonstração bem-sucedida não mostra se a tarefa terá êxito novamente.
- Mean@k mede o acerto médio; Pass^k exige êxito em todas as repetições.
- O estudo da IBM Research não testou o Dots, e o anúncio não confirma acesso no Brasil.
- Antes de delegar ações, registre critérios de sucesso, condições das execuções e pontos de aprovação.
A OpenAI apresentou o Dots em 29 de setembro de 2026 como um agente capaz de trabalhar com computador em nuvem, navegador e aplicativos conectados. A pergunta para quem pensa em delegar uma rotina não é apenas se ele consegue concluí-la uma vez: conseguirá fazê-lo repetidamente, sem omitir etapas ou produzir efeitos indesejados? O anúncio descreve recursos e controles, mas não traz uma medição de consistência do Dots. Para planejar essa avaliação, é útil separar o que a empresa anuncia do que uma pesquisa da IBM Research sobre outros agentes efetivamente mediu.
O que foi anunciado — e o que não foi medido
Segundo a OpenAI, o Dots pode usar seu próprio computador em nuvem, um navegador e aplicativos que o usuário conectou. Isso amplia o escopo de uma solicitação: em vez de só responder, o agente pode percorrer ferramentas e preparar trabalho para revisão. A empresa descreve exemplos de desenvolvimento, análise e produção de conteúdo como possibilidades de uso, não como garantia de que cada execução chegará ao resultado esperado.
A OpenAI diz que é possível inspecionar o computador do agente e criar regras que permitem, submetem à aprovação ou bloqueiam ações específicas. Esses mecanismos ajudam a delimitar permissões e observar o andamento. Não substituem, porém, uma avaliação do resultado final: um agente pode respeitar as permissões e ainda escolher uma informação errada, deixar de concluir uma etapa ou variar sua resposta entre tentativas. A própria OpenAI alerta que dots ainda podem cometer erros e recomenda revisar trabalhos de consequências importantes.
Acerto médio não é repetibilidade
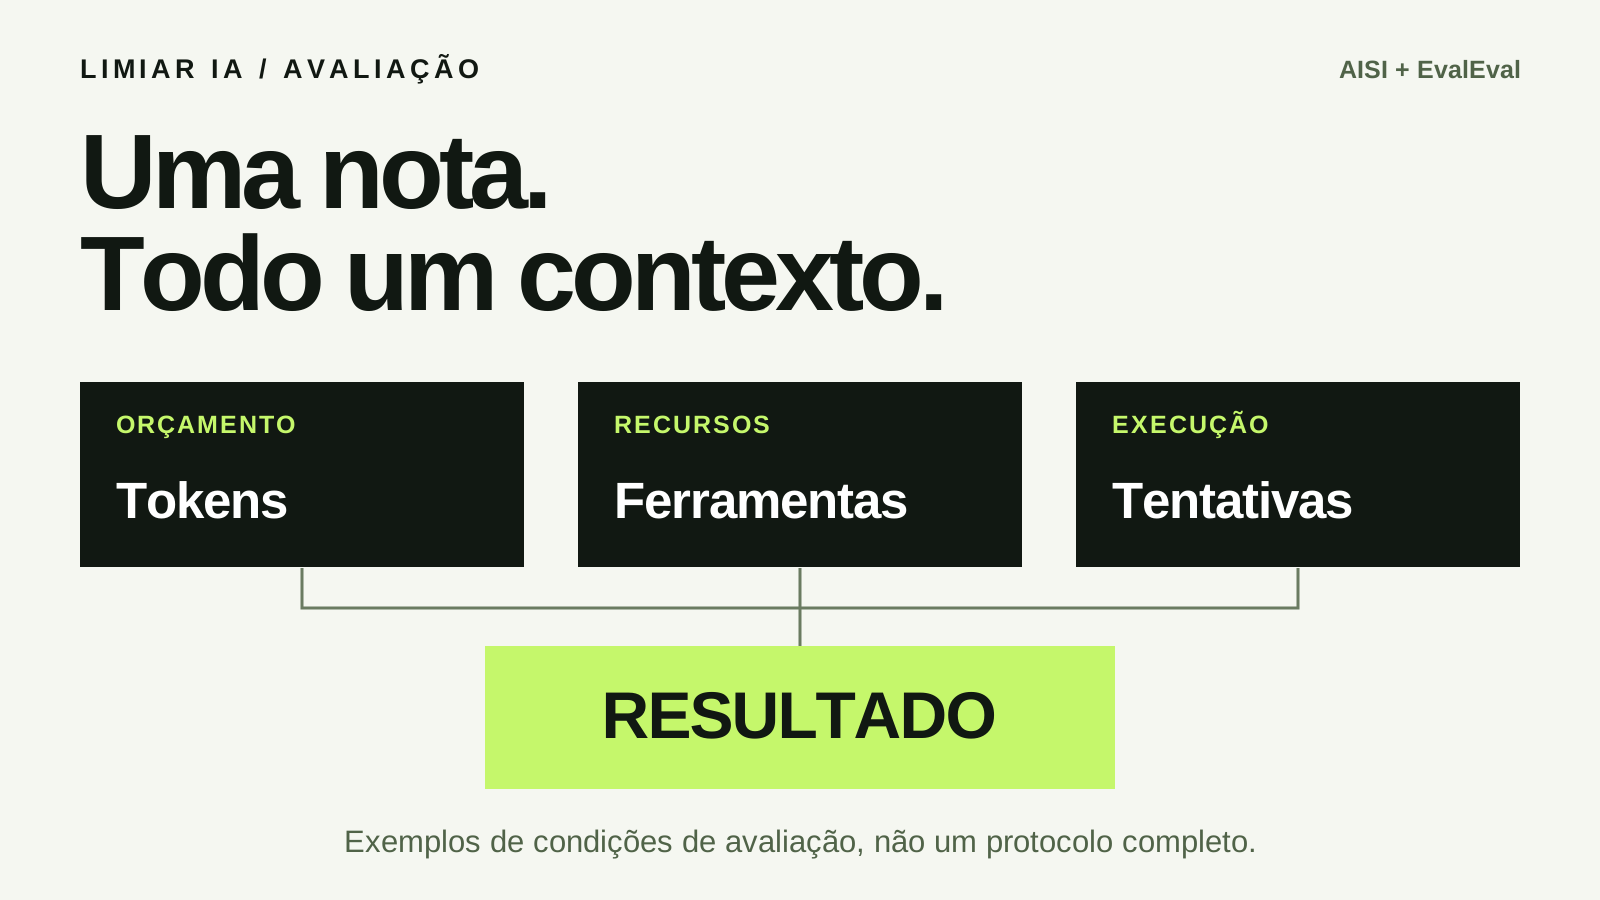
No artigo publicado pela IBM Research em 15 de setembro de 2026, os autores distinguem três perguntas de avaliação. Mean@k é a taxa média de sucesso quando cada tarefa é executada k vezes. Pass^k é a proporção de tarefas que dão certo em todas essas execuções. Pass@k é a proporção com sucesso em pelo menos uma tentativa. Portanto, uma média alta pode coexistir com tarefas que falham ocasionalmente; o indicador de uma tentativa bem-sucedida responde a uma pergunta ainda diferente. Os autores definem a diferença entre Mean@k e Pass^k como lacuna de consistência.
A IBM Research relata que, no AppWorld, um agente ReAct baseado em GPT-4.1 obteve Mean@5 de 77,4%, mas Pass^5 de 53,0%. Isso significa que o resultado médio das tentativas era melhor do que a proporção de tarefas concluídas corretamente em todas elas. Não são resultados do Dots: o agente, as ferramentas e as tarefas do estudo são outros. A distinção importa porque um fluxo que precisa funcionar sempre que solicitado não pode ser aprovado apenas por uma demonstração ou pela taxa média de acerto. Para uma discussão mais ampla sobre como ler avaliações, veja nosso guia de benchmarks de IA.
Como desenhar uma avaliação para a sua tarefa
Comece pelo resultado observável, não pela impressão de que a resposta parece boa. Defina quais entradas o agente receberá, que aplicativos poderá consultar, quais saídas deverá entregar e que condições caracterizam sucesso, falha parcial ou ação proibida. Se o trabalho depende de informações externas, registre também a origem exigida para cada conclusão: acertar uma resposta e atribuí-la à fonte errada são problemas distintos, discutidos em nossa análise sobre procedência em agentes MCP.
Exemplo hipotético: uma equipe pede ao agente que prepare, a partir de documentos autorizados, um rascunho de relatório para aprovação. Ela pode repetir o pedido em condições comparáveis e conferir em cada execução se os documentos corretos foram usados, se as ressalvas aparecem, se o rascunho foi entregue e se nenhuma mensagem foi enviada sem autorização. Nesse exemplo não há medição real nem resultado atribuível ao Dots; trata-se de um roteiro de verificação.
Guarde os registros de cada tentativa e identifique mudanças nas entradas, permissões, versões dos documentos ou estado dos aplicativos. Repita também tarefas de diferentes dificuldades e consequências, separando falhas de interpretação de falhas de acesso ou de execução. Relate lado a lado a taxa média e a proporção de tarefas bem-sucedidas em todas as repetições, com critérios definidos antes de examinar os resultados. Se houver revisão humana ou possibilidade de tentar novamente, explicite isso: um acerto após várias tentativas não equivale a acertar sempre na primeira execução. A quantidade de repetições e o conjunto de tarefas devem refletir o risco do fluxo; nenhuma das fontes estabelece um limiar universal de aprovação para o Dots.
O que o estudo ajuda a investigar — e seus limites
Os autores da IBM Research avaliaram 168 tarefas do AppWorld test_normal com um agente ReAct baseado em GPT-4.1; após gerar diretrizes a partir de uma trajetória inicial por tarefa, testaram cinco novas execuções. Nesse experimento, relataram aumento de Pass^5 de 53,0% para 69,0% com as diretrizes de consistência. O achado sugere uma linha de investigação: localizar decisões instáveis e formular orientações verificáveis antes de repetir a avaliação. Não demonstra que as mesmas diretrizes funcionariam no Dots, nem que um resultado obtido em um conjunto de tarefas se transfira para o trabalho de uma organização.
Disponibilidade e decisão no Brasil
No anúncio de 29 de setembro de 2026, a OpenAI informou a liberação gradual do Dots para usuários Pro e Business Premium em mercados elegíveis e uma versão beta para Enterprise habilitada pelo administrador do espaço de trabalho. A página não identifica o Brasil entre esses mercados; portanto, o acesso local permanece pendente de confirmação, assim como qualquer medição de repetibilidade do produto em fluxos brasileiros. Anúncio, disponibilidade efetiva e evidência de desempenho são coisas diferentes — e a publicação anterior do estudo da IBM Research não altera a data de apresentação do Dots.
Se houver acesso ao produto, a decisão de adotá-lo deve partir de tarefas delimitadas, permissões proporcionais, resultados conferíveis e revisão de ações com consequências. Sem acesso confirmado ou dados específicos do Dots, o procedimento acima é um plano de avaliação, não uma certificação de confiabilidade.
Fontes e referências
- Introducing dots | OpenAIOpenAI News · Consultado em 30/09/2026
- Your Agent Aced the Task. Will It Do It Again?Hugging Face Blog · Consultado em 30/09/2026